フィジカルAI・ロボティクス向け データセット
人がどう動き、物をどう扱うのか。ロボットの学習に欠かせない一人称視点のマルチモーダルデータを、パートナー企業と連携してご提供します。
取り扱いデータセット
2件のデータセット
Xperience Enterprise
100,000時間
9種類の実環境シーンで収録した、大規模な一人称視点マルチモーダルデータセット。ロボット基盤モデルの事前学習に。
- シーン数
- 5,000
- シーンタイプ
- 9種類
RGB映像 
深度 
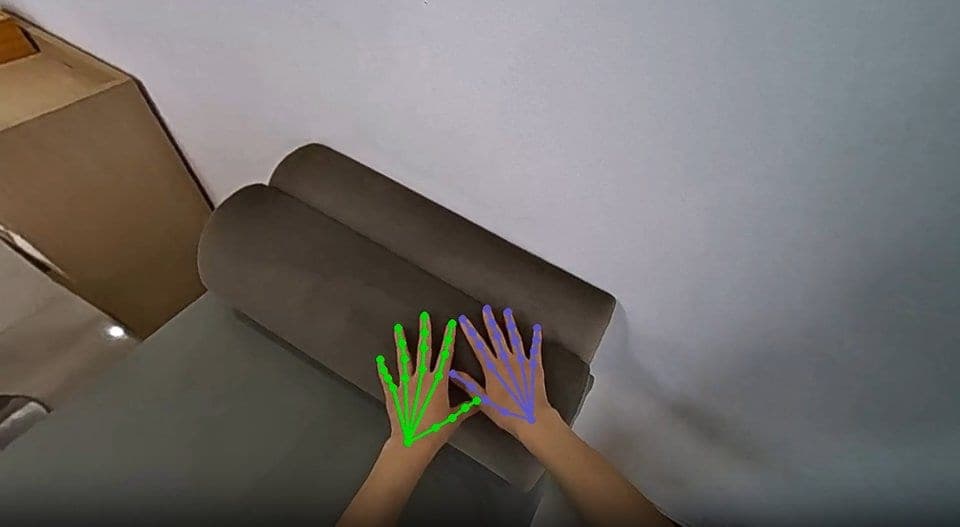
手の骨格
Xperience Enterprise
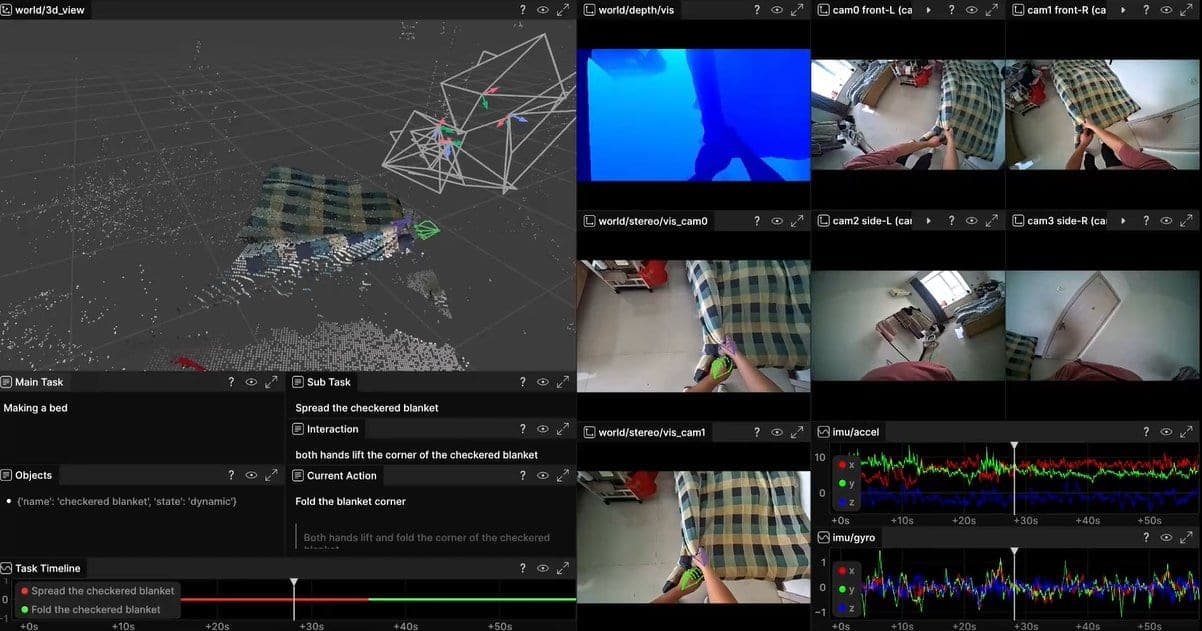
頭部装着型デバイス「HOMIE Gen2」で人の日常動作を一人称視点で収録した商用データセットです。広角映像・IMU・深度・姿勢・セマンティックラベルを同期させ、9種類の実環境シーンにわたってアノテーションを付与しています。
| 収録時間 | 100,000時間 |
|---|---|
| シーン数 | 5,000シーン |
| シーンタイプ | 9種類 |
| モダリティ層 | 9層 |
| 収録デバイス | HOMIE Gen2(頭部装着型マルチモーダル収録デバイス) |
| サンプル | rrd形式(専用ビューアで閲覧) |
収録データの種類
複数のセンサーデータを共通の時間軸で同期しています。
- 広角映像
- IMU(慣性計測)
- 音声
- 平行化ピンホール映像
- カメラ姿勢
- 深度
- 手のモーションキャプチャ
- 全身モーションキャプチャ
- キャプション
計測精度
納品バッチごとに精度を検証しています。
- 自己位置推定(SLAM)
- 1.02 cm
- 6 m の移動での位置誤差
- 深度
- 2.5% 未満
- 4回の撮影・距離 0.38–1.27 m・n=1,876(観測数)での距離誤差
- 手の姿勢推定
- 4.68 mm
- 手の21関節・有効シーケンス12本での関節位置誤差(フレーム単位)
- 動作キャプション
- 96.0%
- 現在の行動の正解率(n=321)
出典:Ropedia公表値(検証日:2026年8月5日)
想定される用途
- ロボット基盤モデルの事前学習
- VLA(視覚・言語・行動)モデルの学習
- ワールドモデルの構築
- ロボットハンドによる器用な操作の学習
- 複数ステップにわたるタスク計画
- 人の実演からの模倣学習
まずは500時間の評価用セットから
100,000時間のフルデータセットに加え、500時間の評価用セットもご用意しています。お客様のモデルや用途への適合性をご確認いただいたうえで、本格導入をご検討いただけます。お気軽にお問い合わせください。
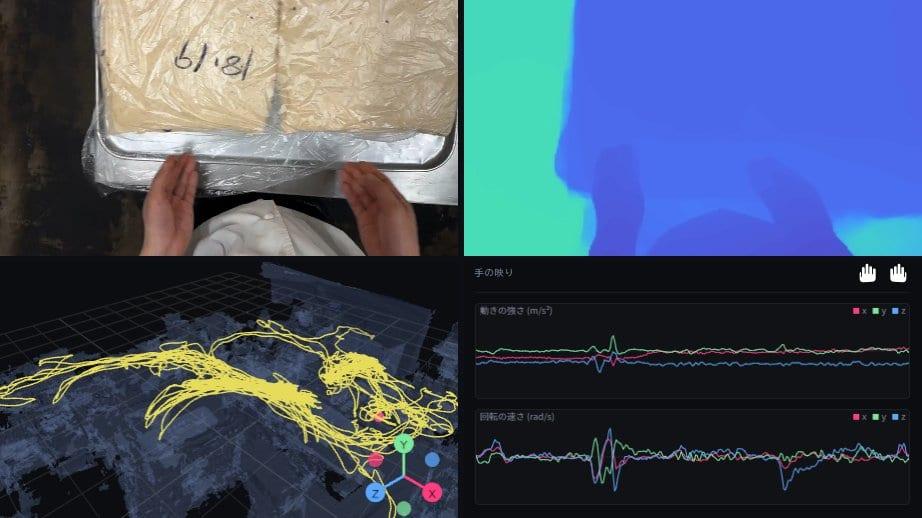
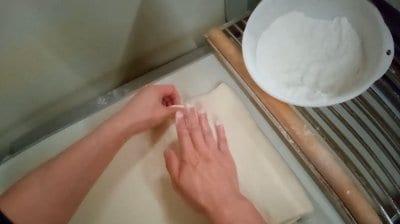
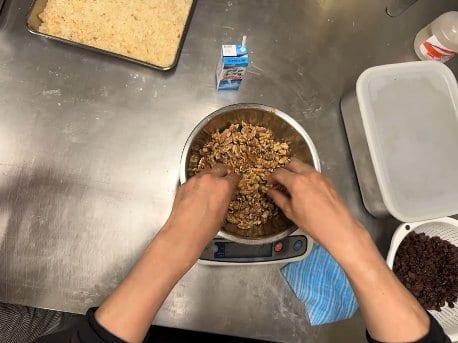
パン生地の成形 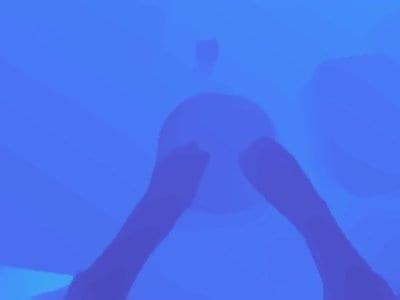
LiDAR深度 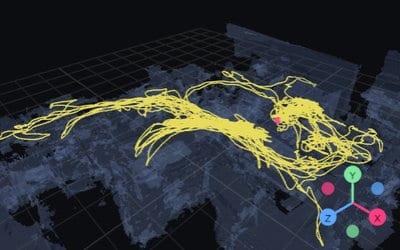
3D移動経路
現場作業データ
日本の現場で働く人の手作業を、一人称視点で記録したデータです。対象業務やセンサー構成をご要件に合わせて設計し、映像に加えて深度や手の動きなども共通の時間軸で同期して収録できます。日本の業務環境に即したロボット学習にご活用ください。
| 収集対象の業種 | 飲食、小売、製造、リフォームなど |
|---|---|
| 提供形態 | 要件に応じた個別収集(切り出し・アノテーションにも対応) |
| 設計できる条件 | 対象業務、収集時間、センサー構成、納品形式 |
| 収録時間 | ご要件に応じて設計 |
撮影デバイス
現場への影響や装着者の負担、データ品質を検証しながら機材を選定しています。
| iPhone Pro(LiDAR搭載、15 Pro以降) | RGB映像、深度、カメラ姿勢、IMU、ハンドトラッキング、空間3Dメッシュを共通の時間軸で記録 |
|---|---|
| スマートグラス | 一人称視点映像 |
| TOBI E2 | 近日対応予定 |
現場作業データの特長
日本の現場の作業を記録
日本の業務環境・道具・手順のもとで行われる実際の手作業を収録します。
収集条件から設計できる
研究目的やモデルの要件に合わせて、対象業務やセンサー構成を決めて収集します。
データの来歴をたどれる
協力先との事前合意、撮影スタッフの同意、管理責任者の承認の記録を各データにひも付けて管理しています。
データセットの選び方
大規模な事前学習には既存データセット、特定業務への適用には個別収集が向いています。
| 項目 | Xperience Enterprise | 現場作業データ |
|---|---|---|
| 提供形態 | 既存データセットのライセンス提供 | 要件に応じた個別収集 |
| 規模 | 100,000時間・5,000シーン | 要件に応じて設計 |
| 収録環境 | 9種類の実環境シーン | 日本国内の飲食・小売・製造などの現場 |
| 主なデータ | 広角映像、深度、IMU、姿勢、ハンドトラッキング、言語アノテーションなど | RGB映像、深度、カメラ姿勢、IMU、ハンドトラッキング、3Dメッシュ(iPhone撮影時) |
| 向いている用途 | ロボット基盤モデルの大規模な事前学習 | 特定業務・日本の現場への適用 |
データの選定から加工まで、 Nextremerがお手伝いします
アノテーション事業で培ったノウハウを生かし、購入したデータをすぐに学習に使える形に整えます。
日本語でのご相談・ご契約
海外パートナーのデータも、Nextremerが窓口となって日本語でご案内します。
用途に合ったデータの選定
研究テーマやモデルの要件をうかがい、適したデータセットと収集条件をご提案します。
追加のアノテーション・データ加工
独自のラベル付けやフォーマット変換など、学習に必要な加工を承ります。